NAVER AI Now
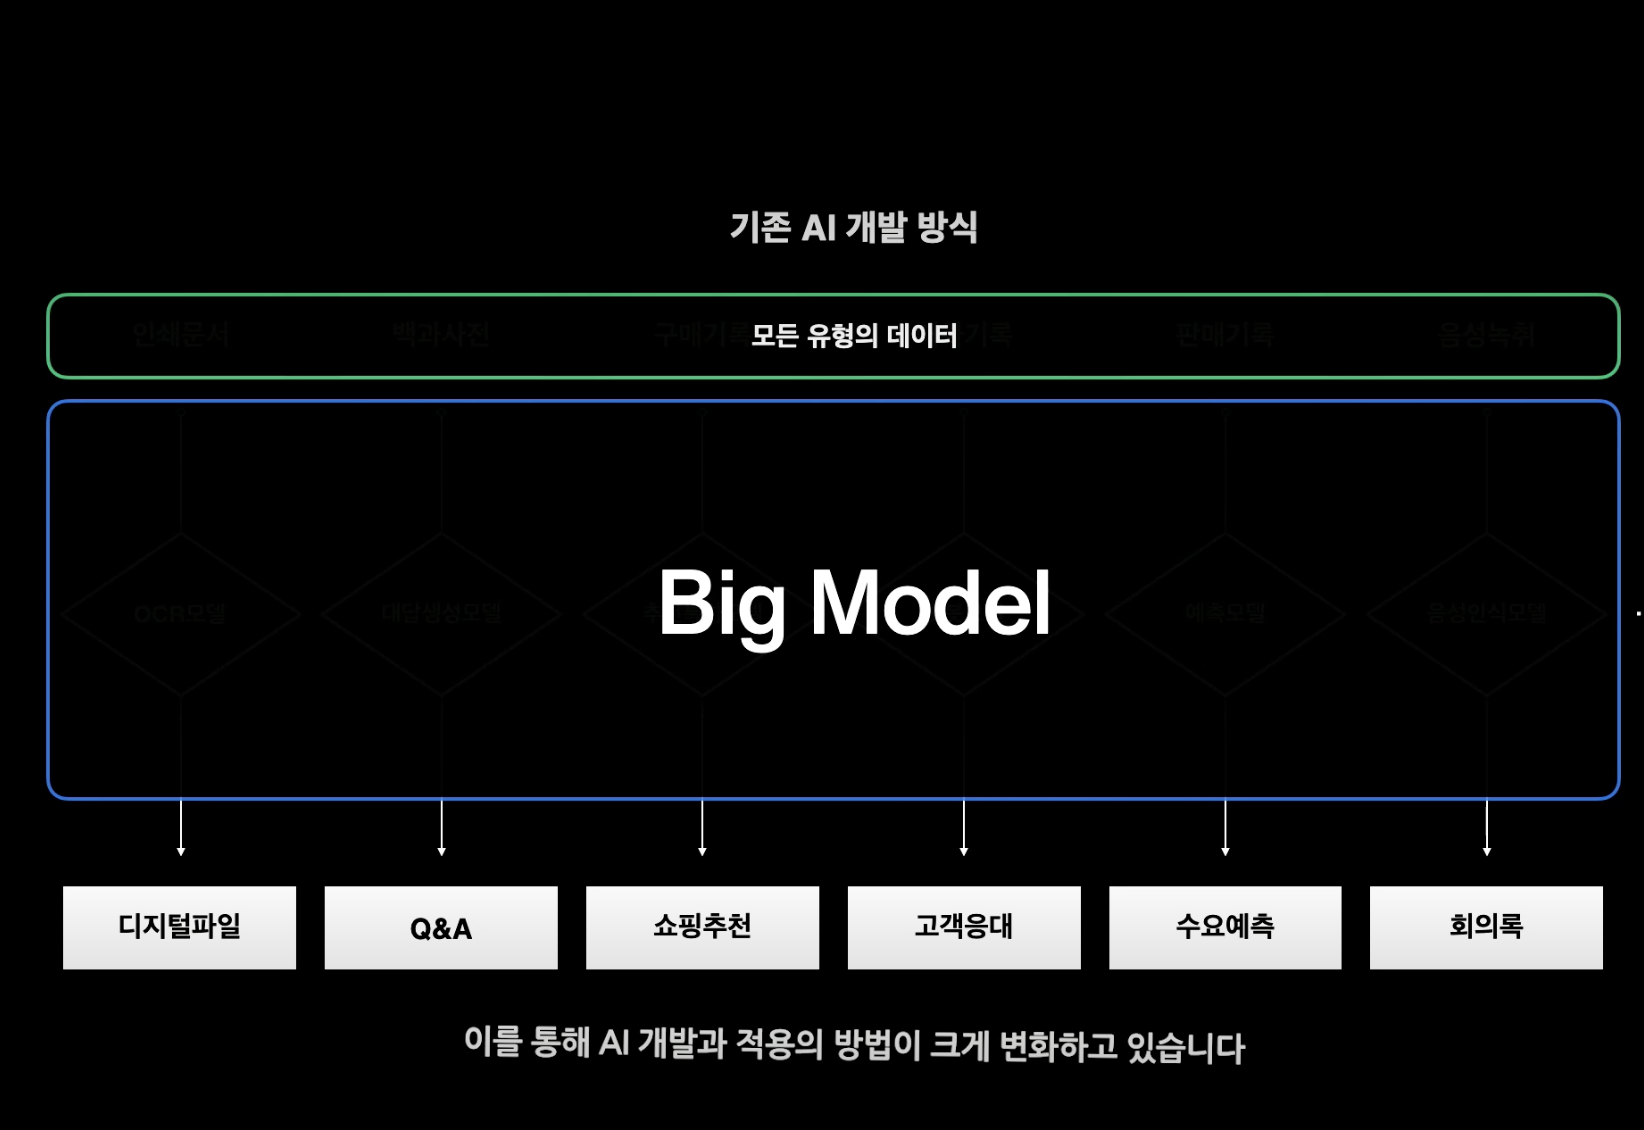
기존 AI 시대
각 문제별로 데이터 확보->정제->모델개발->서비스
- 문제: 긴시간과 많은 리소스 필요, 결과물을 다른데 사용하는데 제한
- 한계: 한정적 자원에 의한 속도와 스케일 한계->새로운 패러다임의 필요성
- 해결: Big model의 일반화와 확장을 통한 플랫폼화
BIG AI 시대
정의
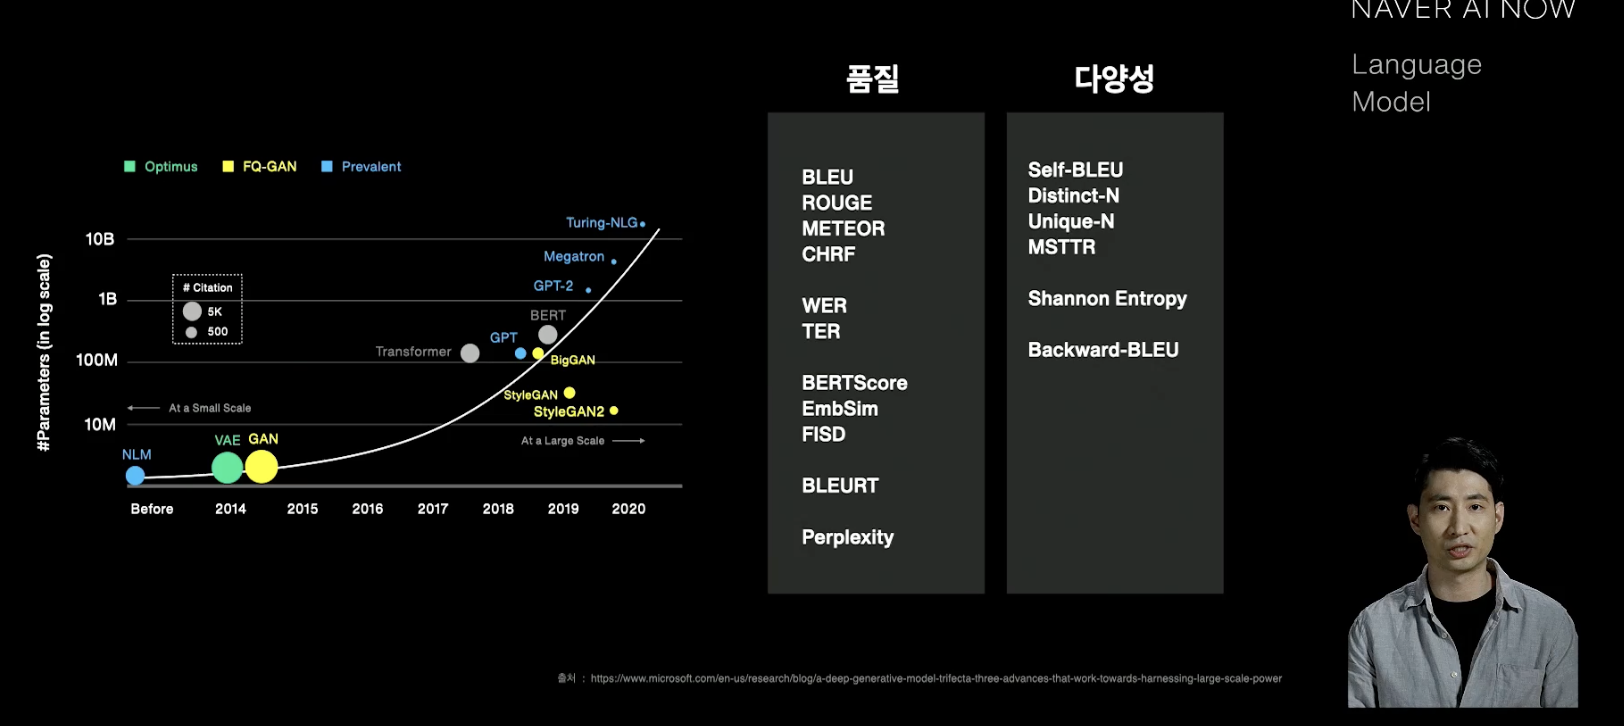
- 새로운 AI 시대: 파라메터 수 높이는 것
- 파라메터 수가 많아짐에 따라 해결 가능한 문제 수가 많아진다.
- 더 큰 모델, 더 빠른 학습이 경쟁 주제이다.
필요한 것
-
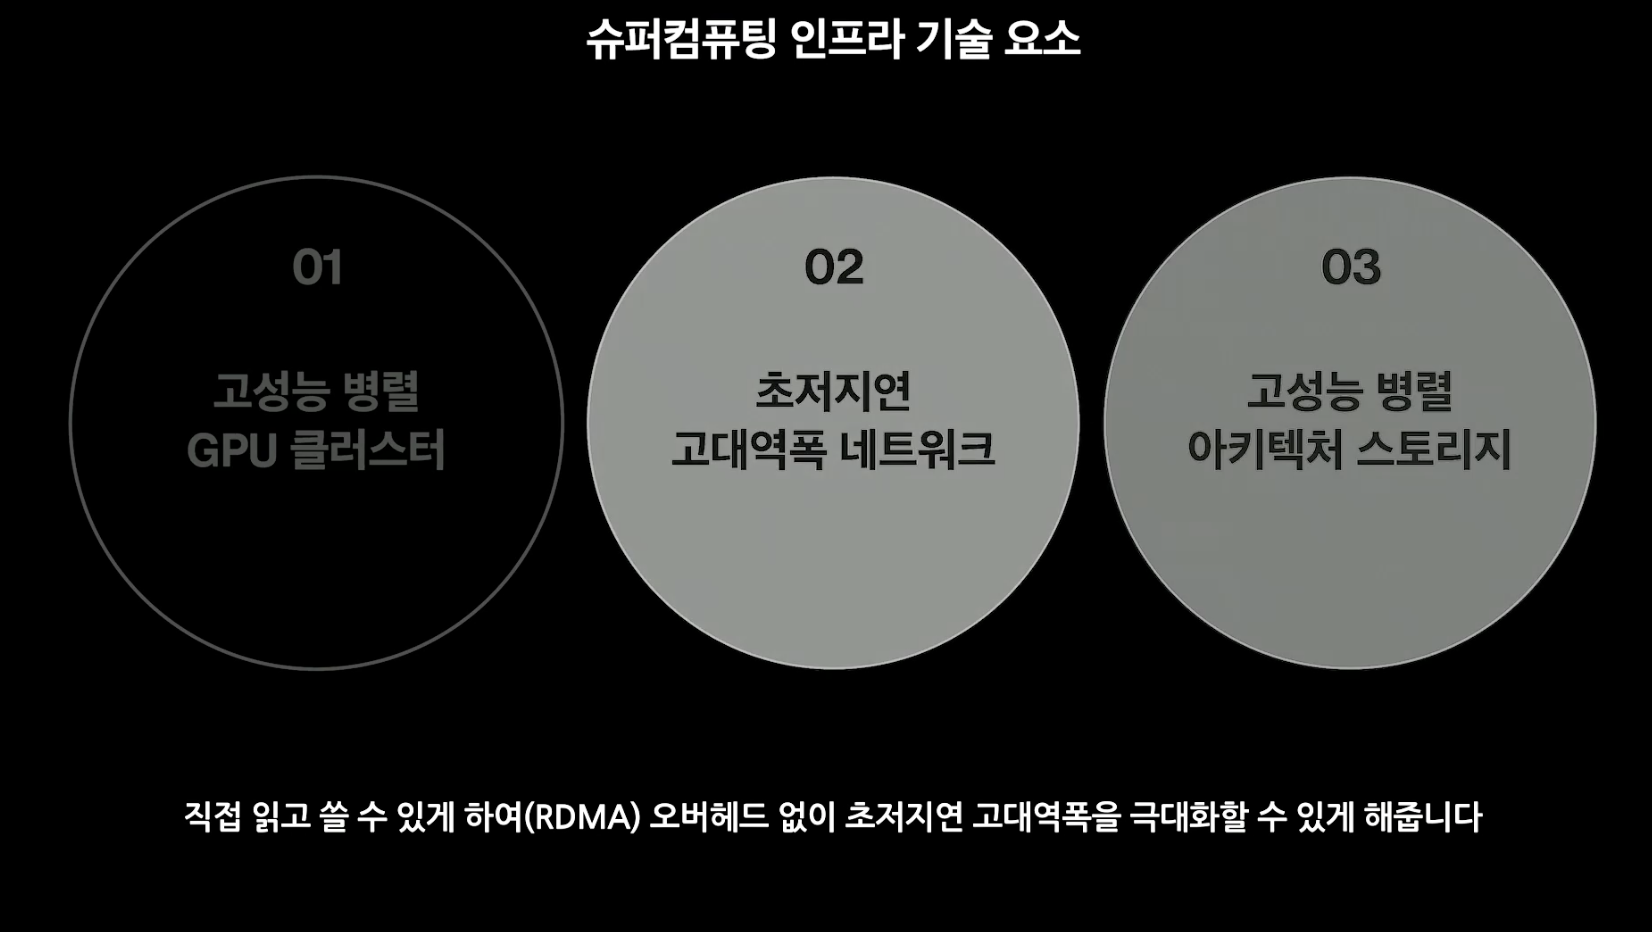
슈퍼컴퓨팅 인프라: 필수, NAVER는 700pf이상 성능을 갖춘 슈퍼 컴퓨터 도입
- 데이터: 고품질 풍부한 데이터, 가장 많은 사용자가 있는 플랫폼에서 나오는 데이터, 한국어 모델
- AI 전문가: 학회 발표 논문 (국내 기업중 최대), 글로벌 공동 연구
방법
비지도학습 방법이 가능하게 만들었다.
모델 규모가 클수록 효율성이 늘어난다. (loss 줄어든다)
모델의 진화
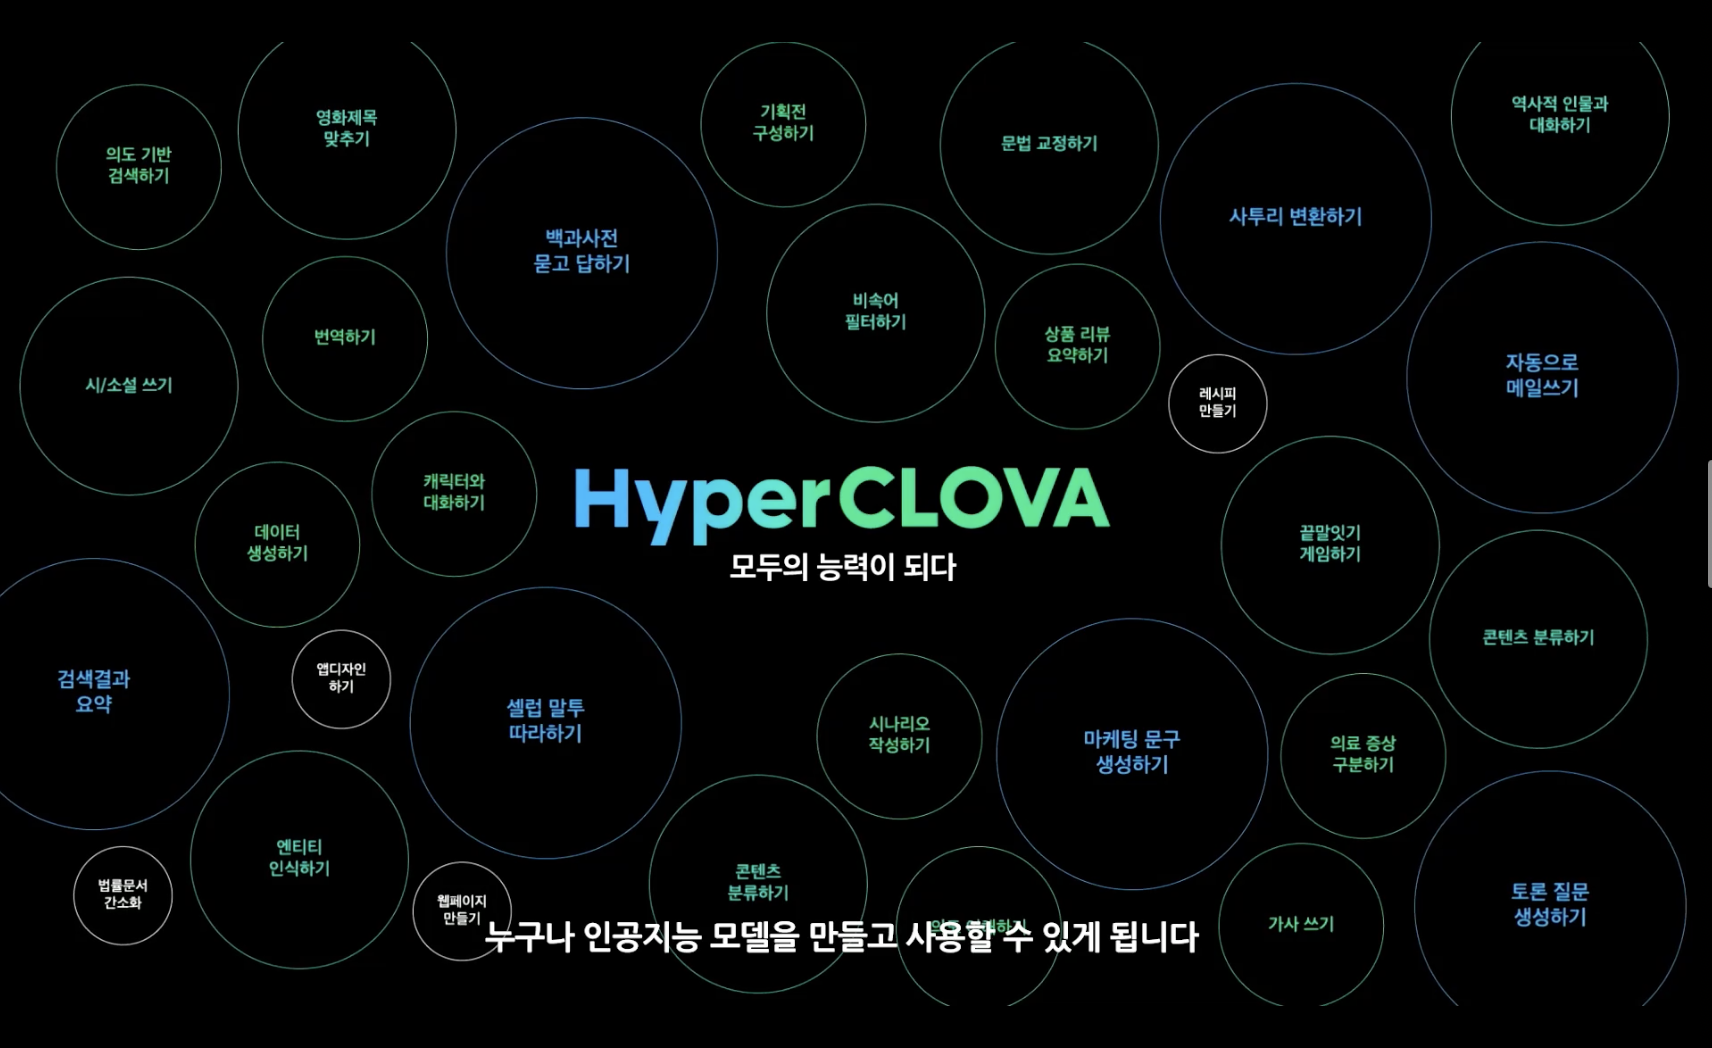
예시) HyperCLOVA 특장점
- 맥락을 이해하는 대화
- 창장을 도와주는 글쓰기
- 크리에이터의 창작
- 그렇다면 창작의 가치는 어떻게 되는가? 이전을 모방하는 창작은 AI도 가능해진다는 뜻이므로 가치가 낮아질 것이다.
- 가치있는 창작이란? 이전에 없던 것을 만드는 것이 될 것이다.
- 크리에이터의 창작
- 정보 요약
- 여러 문서를 읽고 요약해준다.
- 데이터 생성
- 데이터 구축 과정의 비용과 시간 단축
- AI 개발자가 아니어도 누구나 필요한 서비스를 만고, 문제를 해결할 수 있다.
- 그렇다면 AI 개발자로서 나아가야 할 방향은 무엇인가?
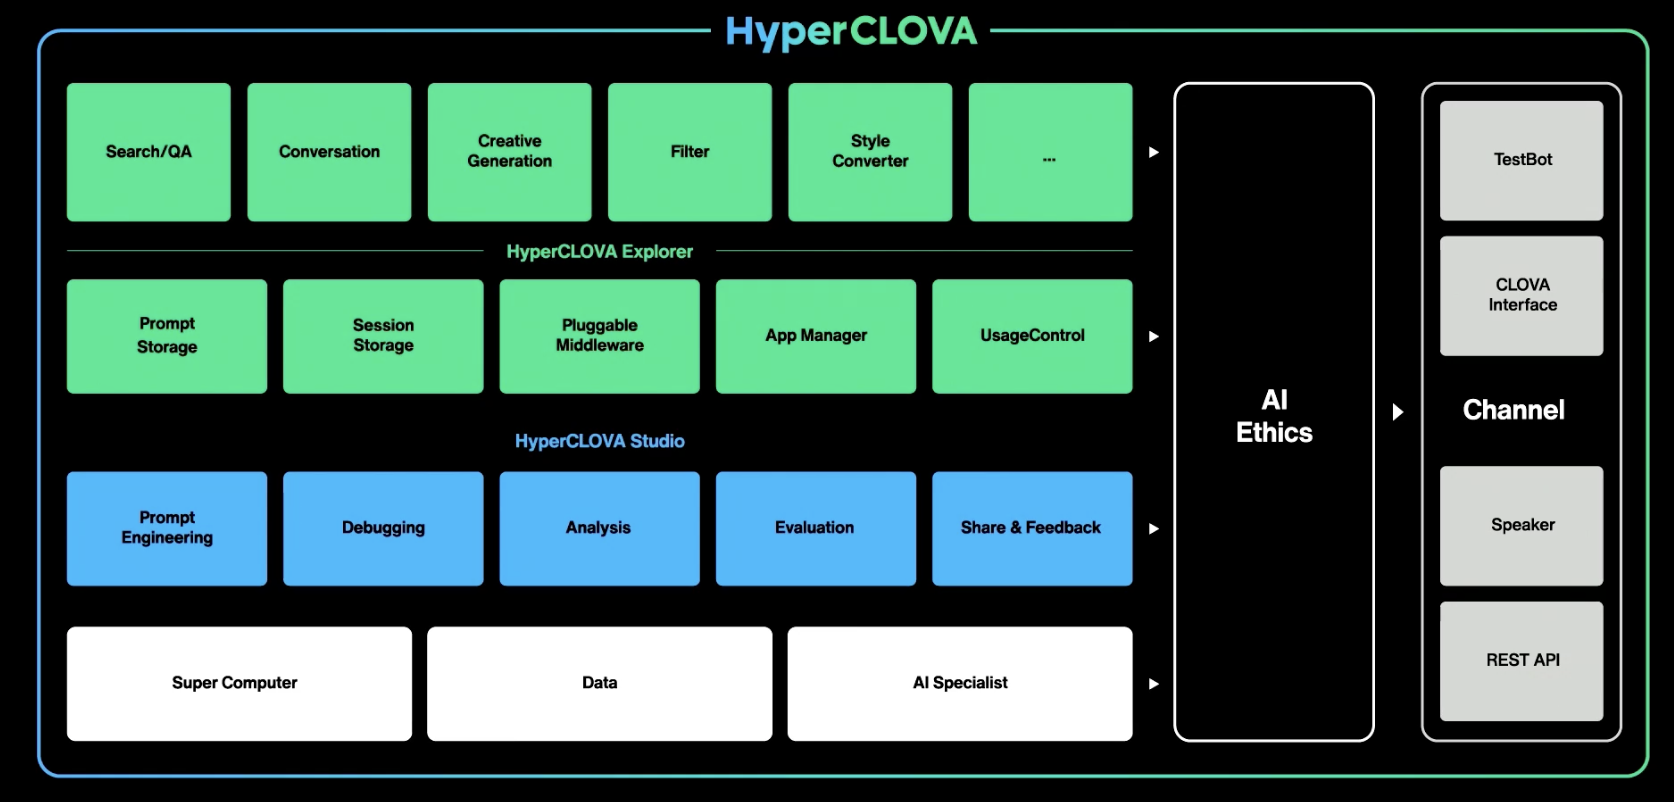
인프라
- GPU 서버 병렬 학습이 필수가 되었다.
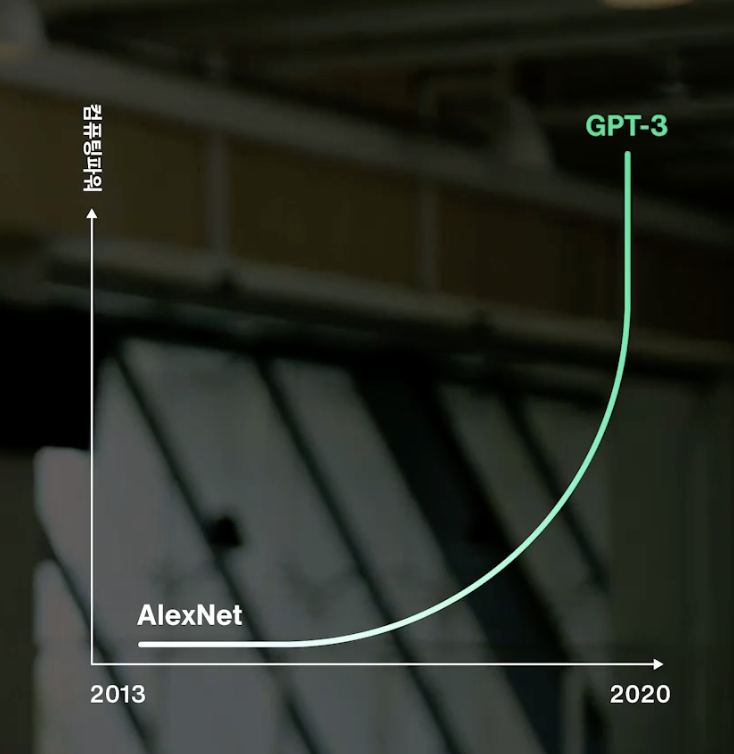
규모
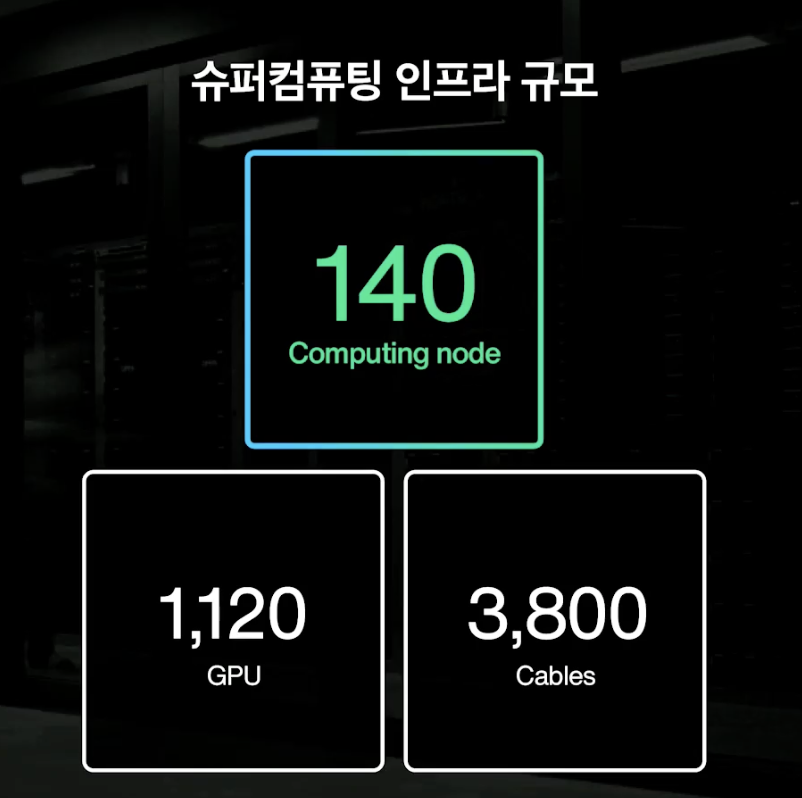
NLP Big Data 수집
딥러닝에서 중요한 것은 좋은 데이터 확보하는 것
- 다양한 내용
- 범용의 구성 (대화, Q&A…등)
- 양질의 정보 (내용을 믿을 수 있는가)
- 영역 선별 모델 개발
- 저품질 문서 필터링: 비속어, 반복단어 등 제거
- 충분한 양
NAVER AI Lab: R&D
공개된 기술 적용 VS 자체 기술 개발: 리더쉽 확보를 위해 자체 기술 개발.
매출의 25%를 개발에 투자하며 그중 AI가 큰 비중을 차지한다.
- AI 연구 동향 핵심
- BIG (모델, 데이터, 개발인력): 연구 중심이 아카데미->기업!!
- AI 배우려면 이제 회사를 가야한다.
- 발표 논문의 상단수를 인턴과 함께 작성했다.
- 연구 결과가 사용자에게 직접적으로 적용된다는 점이 의미있다.
- 서울대, 카이스트와 협업이 국내 최고
- NAVER AI Lab 리더께서 선지원 노고민! 을 부탁하셨다.
AI 윤리 준칙
사람을 위한 AI 개발
다양항 존중 …등 5가지
네이버의 관점
-
누구나 쉽고 빠르게 활용할 수 있는 사람을 위한 일상의 도구
-
예시: Clove carecall (반복 업무 효율성 증가)
HyperCLOVA 기술

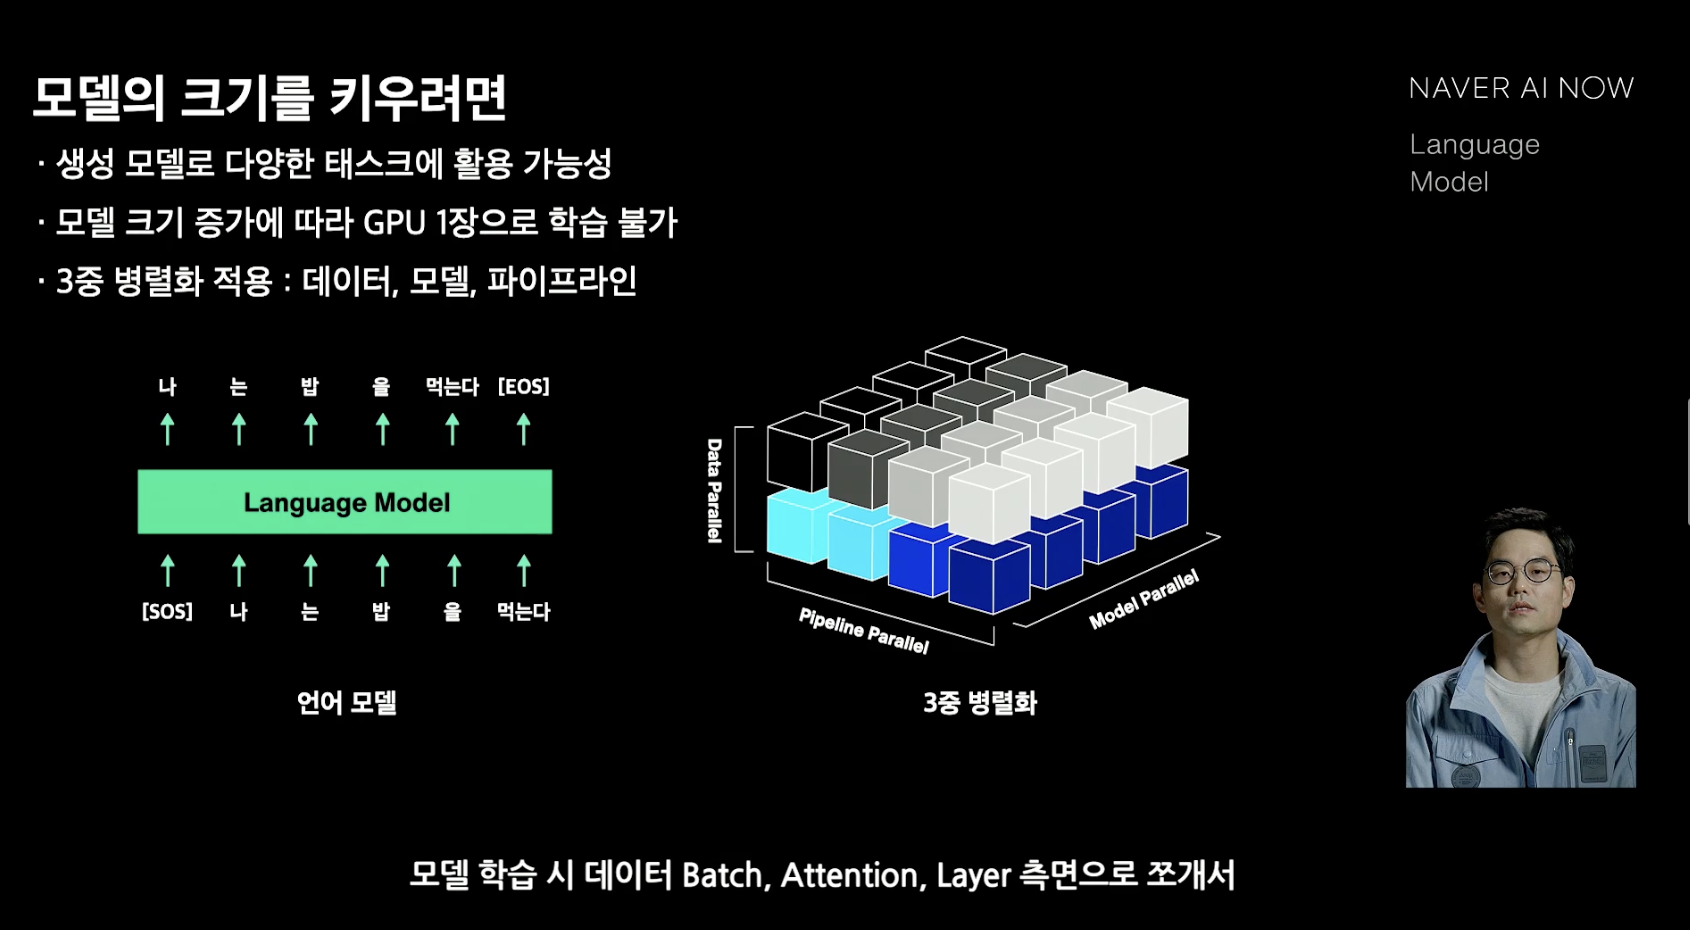
- 현재 모델의 크키가 커지는 속도가 GPU 메모리가 증가하는 속도보다 더 크다.
따라서 큰 모델을 위해서 GPU에 나누어 연산을 수행하고 나중에 합치는 방법이 필수적이며, 3중 병렬화 방법이 현재 적용되고 있다.
- 모델의 크기가 클수록 후반 loss 감소가 크다.